
Güncellendi:
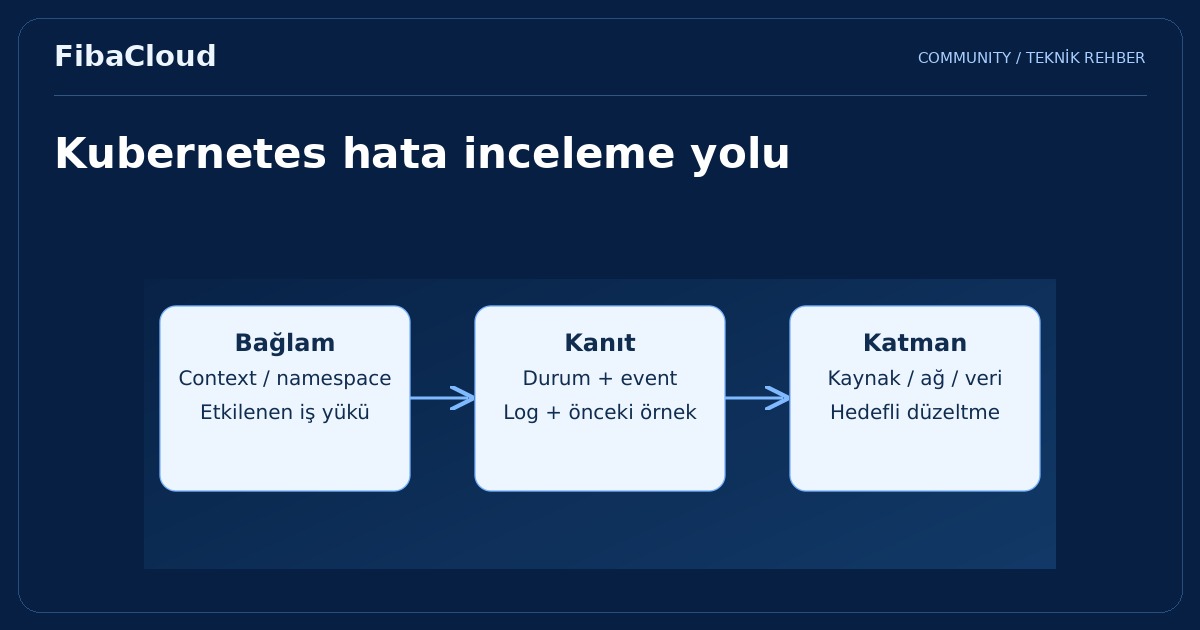
Kubernetes’te iyi hata inceleme, belirtileri doğru katmana ayırmakla başlar. Pending, CrashLoopBackOff, bağlantı hatası veya yavaş yanıt aynı nedenle oluşmaz. Önce bağlamı ve kanıtı kaydedin; yeniden başlatma gibi değişiklikler önemli gözlemleri ortadan kaldırmadan sorunun kaynağını daraltın.
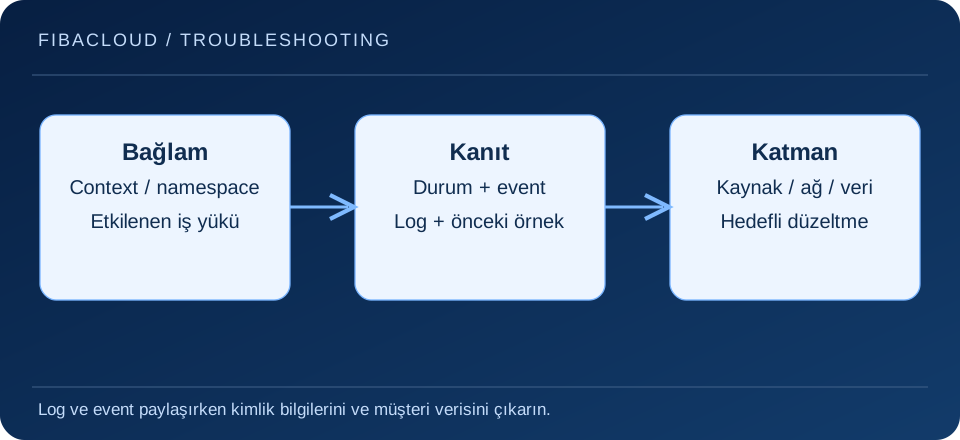
Görseli büyüt →
Doğru kümeyi ve namespace’i kontrol edin
Birden fazla ortamla çalışıyorsanız ilk adım aktif context ve hedef namespace’i doğrulamaktır. Aşağıdaki komutlar durumu incelemek içindir; app ve Pod adını kendi yetkili ortamınızla değiştirin. Erişim reddi alırsanız sorunu çözmek için kendinize gelişigüzel küme yöneticisi yetkisi vermeyin.
kubectl config current-context
kubectl get pods -n app
kubectl describe pod POD_ADI -n app
kubectl get events -n app --sort-by=.metadata.creationTimestamp
Event kayıtlarının saklama süresi sınırlı olabilir. Sorunun başlangıcını, son değişikliği ve tekrar sıklığını kaydedin. Tek bir anlık görüntü aralıklı sorunu açıklamayabilir.
Pending ile yeniden başlatma döngüsünü ayırın
Pending durumunda zamanlama, kaynak talebi, node seçimi, taint/toleration veya PVC bağlama sorunları bulunabilir. Pod event’leri zamanlayıcının gerekçesini gösterir. Kaynak taleplerini rastgele düşürmek yerine gereken kapasiteyi ve yerleşim politikasını inceleyin.
CrashLoopBackOff, container’ın tekrarlayan başarısız başlangıcına işaret eder; tek başına nedeni söylemez. Uygulama çıkış kodu, yapılandırma, dosya izni ve bağımlılık hatalarını loglarla birlikte değerlendirin. Önceki container örneğinin logu yararlı olabilir:
kubectl logs POD_ADI -n app -c CONTAINER_ADI
kubectl logs POD_ADI -n app -c CONTAINER_ADI --previous
Loglar parola, token veya müşteri verisi içerebilir; yalnız gerekli ve temizlenmiş bölümü paylaşın. Pod’u silmeden önce hata bağlamını kaydedin.
Probe ve kaynak sınırlarını inceleyin
Readiness başarısızsa uygulama çalışıyor görünse bile trafiğe alınmayabilir. Liveness başarısızlığı yeniden başlatmaya yol açabilir; uygulamanın normal başlangıç süresini tanımayan bir kontrol döngü oluşturur. Yavaş başlayan uygulamalarda startup probe ihtiyacını değerlendirin.
OOMKilled, bellek sınırı veya sistem baskısıyla ilişkili olabilir; uygulamanın bellek davranışını ve node durumunu birlikte inceleyin. CPU throttling, limit ve talep arasındaki ilişkiyle değerlendirilmelidir. Yalnız limitleri kaldırmak sorunun nedenini çözmez ve komşu iş yüklerini etkileyebilir.
Service erişimini uçtan uca takip edin
Service seçicilerinin Pod etiketleriyle eşleştiğini, hedef portun doğru olduğunu ve uygun endpoint’lerin oluştuğunu kontrol edin. Ardından DNS çözümlemesini, ağ politikasını ve uygulamanın dinlediği adresi inceleyin. Ingress veya gateway gibi dış erişim katmanları ayrıca değerlendirilmelidir.
NetworkPolicy kullanıyorsanız ağ eklentisinin kuralları uyguladığını doğrulayın. Bağlantı sorunu için bütün politikaları kaldırmak yerine hangi kaynak, hedef ve portun gerekli olduğunu belirleyin. TLS hatası, bağlantı reddi ve uygulama HTTP hatası farklı teşhis yollarıdır.
Düzeltmeyi ve sonucu kaydedin
Bir değişikliği küçük kapsamda uygulayın ve beklenen sonucu önceden tanımlayın. Yeni imaj, kaynak ayarı veya erişim kuralının etkisini kullanıcı iş akışıyla doğrulayın. Dağıtım geri alma kararı verirken veritabanı şeması ve dış sistemlerdeki değişikliklerin otomatik geri alınmadığını hesaba katın.
Olay sonrası neden, etkilenen kapsam, uygulanan düzeltme ve erken uyarı fırsatlarını kaydedin. Aynı hatayı tekrar önlemek için test veya alarmı gerçek bulguya bağlayın; yalnız Pod sayısını artırarak kalıcı çözüm elde edildiğini varsaymayın.
Sık sorulan sorular
- CrashLoopBackOff bir Kubernetes hatası mıdır?
-
Bu durum yeniden başlayan container’ın belirtisidir. Uygulama, yapılandırma, izin veya bağımlılık gibi nedenler event ve loglarla incelenmelidir.
- İlk adım Pod’u silmek olmalı mı?
-
Genellikle önce kanıtı toplamak daha yararlıdır. Yeniden oluşturma geçici belirtiyi kaldırabilir fakat nedeni gizleyebilir; işlemin uygulama etkisini değerlendirin.
Sonraki adım
Nesne ilişkilerini temel Kubernetes kavramları ve tekrarlanan olayları işletim planı ile birlikte ele alın.
Kaynaklar
- Troubleshooting Applications | Kubernetes
- Debug Running Pods | Kubernetes
- Security Checklist | Kubernetes
- kubectl get | Kubernetes
- kubectl describe | Kubernetes
- kubectl logs | Kubernetes
- kubectl config current-context | Kubernetes
- Liveness, Readiness, and Startup Probes | Kubernetes
- Kubernetes — Pod ve container kaynak yönetimi, CPU ve bellek sınırları