Güncellendi:
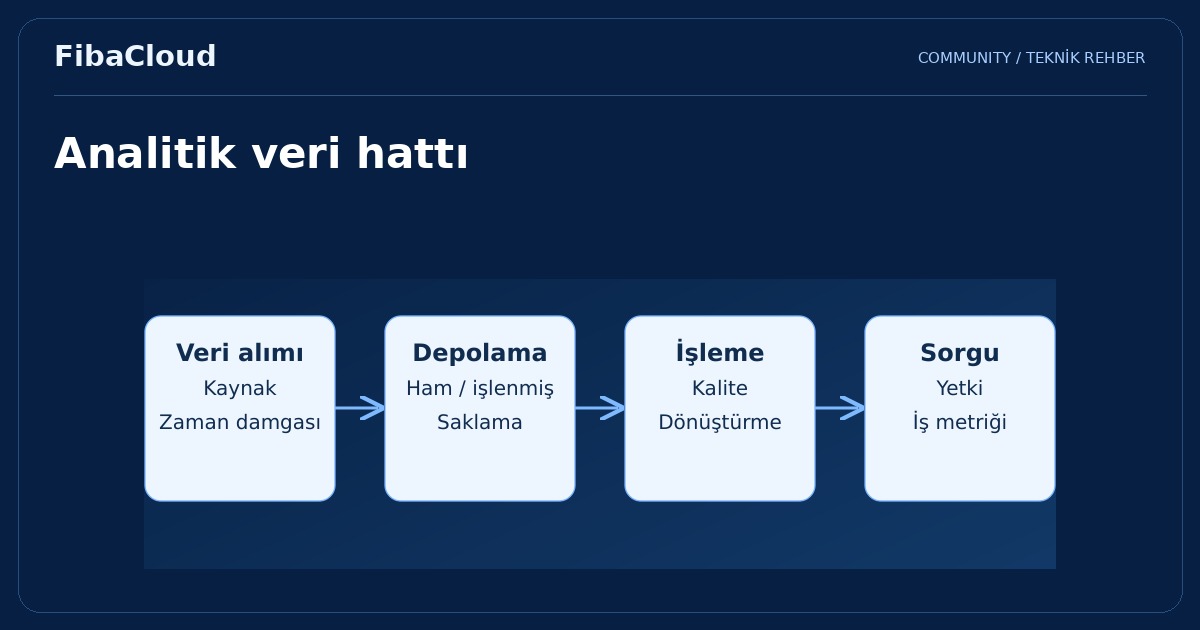
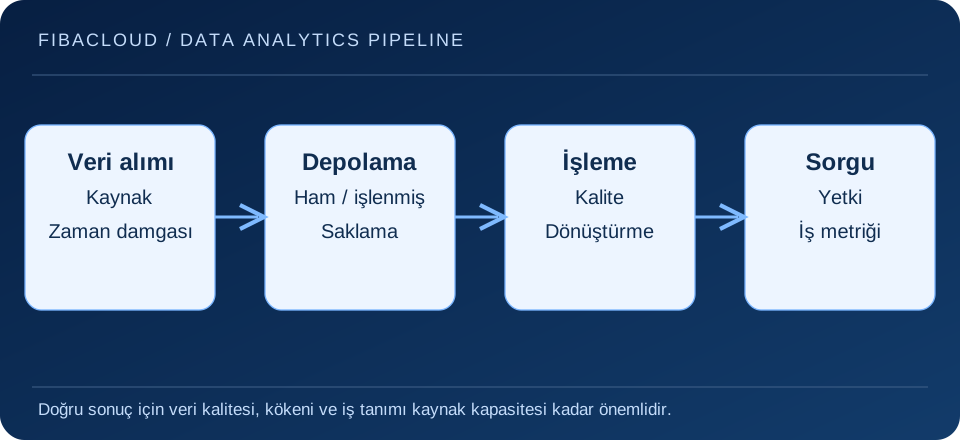
Bulut tabanlı büyük veri analitiği, veriyi toplama, saklama, işleme ve sorgulama işlerinin uygun bulut kaynakları üzerinde yürütülmesidir. “Büyük” ifadesi yalnız dosya boyutuna bağlı değildir; veri üretim hızı, çeşitliliği ve işleme gereksinimi de tasarımı etkiler. Amaç mümkün olduğunca veri biriktirmek değil, belirli bir iş sorusuna güvenilir ve zamanında yanıt üretmektir.
Görseli büyüt →
Önce iş sorusunu ve veri kaynağını belirleyin
Günlük sipariş raporu, cihaz arızası sinyali ve uygulama hata analizi aynı gecikme hedefini taşımaz. Sonucun ne sıklıkta kullanılacağını, ne kadar gecikmenin kabul edileceğini ve yanlış sonucun etkisini belirleyin. Bu kararlar mimariyi veri miktarı kadar etkiler.
Kaynak sistem, veri sahibi, güncellenme sıklığı ve alan tanımlarını kaydedin. Örneğin “satış” metriğinde iptal, iade, para birimi ve zaman dilimi nasıl ele alınıyor açık olsun. Teknik olarak doğru bir sorgu, belirsiz iş tanımı nedeniyle yanıltıcı sonuç üretebilir.
Toplu işleme ile akış işlemeyi ayırın
Toplu işleme, belirli aralıkta biriken veriyi işler. Akış işleme, gelen olayları daha kısa gecikmeyle değerlendirmek için kullanılır. Akış yaklaşımı daha karmaşık durum ve hata yönetimi gerektirebilir; günlük rapor için her zaman gerekli değildir.
Geç gelen, yinelenen veya sırası değişen olayları nasıl ele alacağınızı belirleyin. Olay zamanı ile sisteme giriş zamanı farklı olabilir. Tekrar işlenen bir kayıt toplamları iki kez artırmamalıdır. Yeniden çalıştırılabilir dönüşüm adımları hatadan toparlanmayı kolaylaştırır.
Depolama biçimini sorgu ihtiyacına göre seçin
Ham veriyi ve analiz için düzenlenmiş çıktıyı farklı amaçlarla saklayabilirsiniz. Sütun tabanlı biçimler, örneğin Parquet, analitik sorgularda yalnız ilgili alanların okunmasına yardımcı olabilir. Kazanç; veri düzeni, sorgu, sıkıştırma ve kullanılan motorun davranışına bağlıdır.
Bölümleme anahtarlarını erişim örüntüsüyle seçin. Çok sayıda küçük dosya veya aşırı bölümleme yönetim ve sorgu yükü oluşturabilir. Saklama süresini ve silme politikasını veri sahibinin gereksinimleriyle belirleyin; her kopyayı süresiz tutmayın.
Veri kalitesi ve erişimi ayrı kontrollerle yönetin
- Beklenen şema, zorunlu alan ve geçerli değer aralıklarını kontrol edin.
- Eksik, yinelenen veya bozuk kayıtların işlenme yöntemini tanımlayın.
- Verinin hangi kaynaktan ve hangi dönüşüm sürümünden geldiğini izleyin.
- Ham kişisel veri ile rapor erişimini farklı yetkilerle sınırlandırın.
- Hatalı veri yayımlandığında yeniden üretim ve düzeltme yolunu hazırlayın.
Anonimleştirme veya maskeleme kararlarını kullanım amacına göre değerlendirin. Geliştirme ekibinin analiz çıktısını görmesi, bütün ham verilere erişmesi gerektiği anlamına gelmez.
FibaCloud üzerinde kapasiteyi nasıl planlarsınız?
Uygulamanızın hesaplama, bellek, disk I/O ve ağ ihtiyacını ölçün. Apache Spark gibi araçların kurulumu ve işletimi ayrı sorumluluklardır; belirli bir yönetilen analitik hizmetin hazır sunulduğunu varsaymayın. Gereken yazılım ve erişim modeliyle mevcut altyapı seçeneklerini karşılaştırın.
Pilotta temsil edici veriyle süre, kaynak kullanımı ve sonuç doğruluğunu kontrol edin. Depolama bedelinin yanında taranan veri, geçici çalışma alanı ve ortamlar arası aktarımı hesaba katın. Kaynak artırmadan önce veri yerleşimini ve sorgu planını incelemek gereksiz maliyeti sınırlayabilir.
Sık sorulan sorular
- Her analiz projesi dağıtık işlem motoru gerektirir mi?
-
Hayır. Veri hacmi, sorgu süresi ve ekip ihtiyacı uygunsa daha basit bir veritabanı veya tek sunucu çözümü yeterli olabilir.
- Daha fazla kaynak daha doğru analiz sağlar mı?
-
Hayır. Kaynaklar işlem kapasitesini etkiler; veri kalitesi, iş tanımı ve dönüşüm mantığı ayrıca doğrulanmalıdır.
Sonraki adım
Veri üretim tarafını IoT rehberi, bütçe modelini bulut maliyet optimizasyonu ile birlikte planlayın.