Güncellendi:
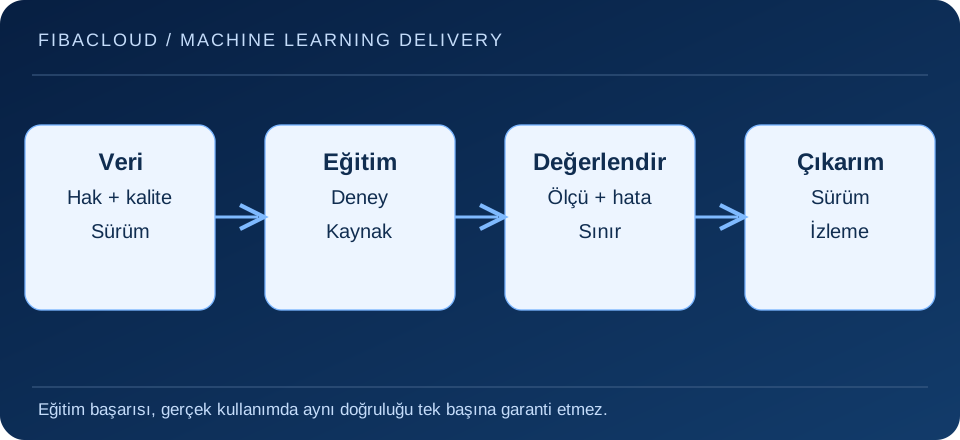
Bulut altyapısı yapay zekâ ve makine öğrenmesi projelerinde veri hazırlama, model eğitimi ve tahmin sunumu için kullanılabilir. Bu aşamaların kaynak ve işletim ihtiyaçları farklıdır. Doğru yaklaşım, önce iş hedefini ve değerlendirme ölçüsünü belirlemek, sonra uygun hesaplama ve veri düzenini seçmektir; daha büyük kaynak her zaman daha iyi model üretmez.
Görseli büyüt →
İş hedefini model görevine çevirin
Talep tahmini, belge sınıflandırma ve kullanıcıya yanıt üretme aynı başarı ölçüsüne sahip değildir. Hangi hatanın kabul edilebilir olduğunu ve sonucun nasıl kullanılacağını belirleyin. Bazı süreçlerde insan değerlendirmesi veya basit kurallar uygun başlangıç olabilir.
Yalnız teknik doğruluk ölçüsünü değil gecikme, işlem maliyeti ve yanlış sonucun iş etkisini de izleyin. Modelin yardımcı olduğu kararla doğrudan verdiği karar arasındaki sorumluluk sınırını açıkça tanımlayın.
Veri hazırlığını ayrı bir iş yükü olarak planlayın
Verinin kaynağı, kullanım hakkı, kişisel veri kapsamı ve güncellenme sıklığını kaydedin. Veri dönüştürme, etiketleme ve kalite kontrolleri önemli kaynak tüketebilir. Model eğitimine geçmeden eksik veya hatalı verilerin nasıl ele alınacağını belirleyin.
Eğitim, doğrulama ve test ayrımını gerçek kullanım koşullarına göre yapın. Aynı kullanıcı veya birbirine çok benzeyen kayıtlar farklı kümelere gelişigüzel dağılırsa sonuç olduğundan iyi görünebilir. Veri sürümü olmadan deneyleri karşılaştırmak zorlaşır.
Eğitim ve çıkarım kapasitesini ayırın
| Aşama | Öncelikli ölçüler |
|---|---|
| Veri hazırlama | Disk/ağ akışı, bellek ve dönüşüm süresi. |
| Eğitim | Model/veri boyutu, CPU/GPU kullanımı, bellek ve deney süresi. |
| Çıkarım | İstek gecikmesi, eşzamanlı kullanım, hata oranı ve birim maliyet. |
GPU, uygun model ve yazılımda hızlandırma sağlayabilir; her görevde zorunlu veya daha ekonomik değildir. Modelin belleğe sığması, veri aktarımı ve sürücü uyumu birlikte kontrol edilir. Eğitimde iyi çalışan yapılandırmayı üretim çıkarımına doğrudan kopyalamayın.
Deneyi ve model paketini sürümleyin
Kaynak kod, veri, parametre, çalışma ortamı ve sonuç ilişkisini kaydedin. MLflow gibi araçlar deney izlemeye yardımcı olabilir; araç kurulumu ve yönetimi ayrıca planlanır. Model dosyasının yanında beklenen girdi şemasını ve ön işleme adımlarını da saklayın.
Yayın öncesinde temsili ve hatalı girdileri değerlendirin. Erişim kimliklerini model veya kaynak kod dosyasına gömmeyin. Hassas verinin loglara veya üçüncü taraf model hizmetlerine hangi koşulda aktarılabileceğini belirleyin.
Üretimde kalite ve geri dönüş yolu
Veri dağılımı değişebilir; eski test sonucu yeni kullanımı tam temsil etmeyebilir. Girdi kalitesi, yanıt davranışı ve uygun çıktı değerlendirmelerini izleyin. Otomatik güncelleme veya yeniden eğitim öncesinde kabul koşullarını tanımlayın.
FibaCloud üzerinde çalışacak uygulamanız için mevcut hesaplama, depolama ve ağ seçeneklerini gereksinimle eşleştirin. Belirli bir hazır AI platformu, GPU veya model hizmetini kapsam doğrulaması olmadan varsaymayın. Önceki model sürümüne geçişi veri ve arayüz uyumuyla birlikte test edin.
Sık sorulan sorular
- Eğitim ile çıkarım aynı altyapıyı gerektirir mi?
-
Her zaman değil. Eğitim toplu ve yoğun hesaplama isterken çıkarım gecikme ve eşzamanlı istek hedefleriyle yönetilebilir.
- Modeli yeniden eğitmek her kalite sorununu çözer mi?
-
Hayır. Girdi hatası, hedef tanımı, veri dağılımı ve entegrasyon da incelenmelidir. Yeni model ayrıca değerlendirilmelidir.
Sonraki adım
Öğrenme temelini yapay zekâ eğitimi ve uygulama teslimini kontrollü yayın süreci ile tamamlayın.